среда, 20 ноября 2019 г.
вторник, 26 декабря 2017 г.
Сравнение S7-2 и Т5-4
По традиции DWH работает на серверах , отслуживших свое в биллинге
Такой подход кроме очевидных плюсов , несет в себе и определенные минусы .
Один из самых больших минусов - невозможность распараллелить часть задач DWH . По простому - отчеты плохо параллелятся , некоторые вообще никак . То есть скорость получения отчета зависит от скорости одного потока CPU , и ускорить привычным способом - задействовать N потоков нельзя .
Скорость же потока определяется частотой и архитектурой процессора , и применить более мощный CPU - см. традиции . То есть отчеты получаются медленно ( по крайней мере с точки зрения пользователей)
Поэтому , плюс еще ряд причин повлиял - было решено попробовать запустить DWH на новом сервере S7-2
Старый сервер Т5-4
System Configuration: Oracle Corporation sun4v SPARC T5-4
Memory size: 1571840 Megabytes
================================ Virtual CPUs ================================
CPU ID Frequency Implementation Status
------ --------- ---------------------- -------
0 3600 MHz SPARC-T5 on-line
1 3600 MHz SPARC-T5 on-line
2 3600 MHz SPARC-T5 on-line
Под DWH были задействованы 3 CPU из четырех , всего 386 потоков
Напомню также , что Т5-4 был еще недавно одним из топовых серверов класса Hi-End
Совсем другое дело S7-2 , который позиционируется Ораклом как low-cost соперник Х86 серверов .
System Configuration: Oracle Corporation sun4v SPARC S7-2
Memory size: 522496 Megabytes
================================ Virtual CPUs ================================
CPU ID Frequency Implementation Status
------ --------- ---------------------- -------
0 4267 MHz SPARC-S7 on-line
1 4267 MHz SPARC-S7 on-line
2 4267 MHz SPARC-S7 on-line
Всего 2 CPU , 128 потоков
После переезда на S7-2 -
Первоначально у нас было впечатление , что нагрузка выросла примерно вдвое -
с 30 до 60% CPU
Но далее нагрузка продолжала расти , почти до 100% , мы были в некотором недоумении и полагали эксперимент неудачным
Однако причина оказалась проста - скорость выполнения отчетов выросла
Для одних отчетов скорость увеличилась на 20-30%
Ряд весьма тяжелых отчетов ускорился в 2-2.5 раза !
В результате пользователи быстро получив один отчет моментально запускали следующий , что в итоге и дало почти 0 Idle
В целом эксперимент признан удачным , ключевое - резко выросла скорость работы одного потока .
вторник, 16 мая 2017 г.
SOHO от Oracle
Новая добыча - сервер S7-2
System Configuration: Oracle Corporation sun4v SPARC S7-2
Memory size: 260352 Megabytes
CPU ID Frequency Implementation Status
------ --------- ---------------------- -------
0 4267 MHz SPARC-S7 on-line
По сравнению с М7 - сильно быстрее
S7-2 aes-256 ige for 3s on 8192 size blocks: 36779 blowfish cbc for 3s on 8192 size blocks: 44702
M7-4 aes-256 ige for 3s on 8192 size blocks: 18929 blowfish cbc for 3s on 8192 size blocks: 26523
Новая добыча - сервер S7-2
System Configuration: Oracle Corporation sun4v SPARC S7-2
Memory size: 260352 Megabytes
CPU ID Frequency Implementation Status
------ --------- ---------------------- -------
0 4267 MHz SPARC-S7 on-line
По сравнению с М7 - сильно быстрее
S7-2 aes-256 ige for 3s on 8192 size blocks: 36779 blowfish cbc for 3s on 8192 size blocks: 44702
M7-4 aes-256 ige for 3s on 8192 size blocks: 18929 blowfish cbc for 3s on 8192 size blocks: 26523
среда, 28 октября 2015 г.
Новый танк
Добрались до нового процессора от Oracle - M7
System Configuration: Oracle Corporation sun4v SPARC T7
================================ Virtual CPUs ================================
CPU ID Frequency Implementation Status
------ --------- ---------------------- -------
0 4133 MHz SPARC-M7 on-line
1 4133 MHz SPARC-M7 on-line
2 4133 MHz SPARC-M7 on-line
3 4133 MHz SPARC-M7 on-line
OpenSSL speed T7
hmac(md5) for 3s on 8192 size blocks: 490246
blowfish cbc for 3s on 8192 size blocks: 43357
4096 bit public rsa's for 10s: 42646
OpenSSL speed T5
hmac(md5) for 3s on 8192 size blocks: 382719
blowfish cbc for 3s on 8192 size blocks: 34591
4096 bit public rsa's for 10s: 29911
Реальная база работает в 2 раза быстрее
System Configuration: Oracle Corporation sun4v SPARC T7
================================ Virtual CPUs ================================
CPU ID Frequency Implementation Status
------ --------- ---------------------- -------
0 4133 MHz SPARC-M7 on-line
1 4133 MHz SPARC-M7 on-line
2 4133 MHz SPARC-M7 on-line
3 4133 MHz SPARC-M7 on-line
OpenSSL speed T7
hmac(md5) for 3s on 8192 size blocks: 490246
blowfish cbc for 3s on 8192 size blocks: 43357
4096 bit public rsa's for 10s: 42646
OpenSSL speed T5
hmac(md5) for 3s on 8192 size blocks: 382719
blowfish cbc for 3s on 8192 size blocks: 34591
4096 bit public rsa's for 10s: 29911
Реальная база работает в 2 раза быстрее
понедельник, 16 марта 2015 г.
пятница, 6 июня 2014 г.
Практическое применение Ethernet fabric ч.3
Ethernet Fabric - практическое применение ч. 3
Как я уже говорил , для технологии Oracle standby очень важно обеспечить отказоустойчивую и низколатентную связь между серверами . Казалось бы , что проще - взять отдельные коммутаторы типа Циски и соединить с их помощью Primary и Standby
Примерно так :
Все это будет замечательно работать , пока кто-нибудь случайно не дернет оптику или повредит ее.
Примечание - Primary и Standby лучше размещать на разных площадках , пусть и недалеко друг от друга . Изображен именно такой вариант .
Для борьбы с повреждениями линий надо проложить их несколько
Сделали транк , все хорошо .
Но - у нас остается одна линия от сервера до коммутатора
Ставим двухпортовую сетевую карточку , поднимаем IPMP
Все хорошо , все замечательно работает , все довольны .
Длится сие счастье ровно до того момента , когда связь между площадками все же падает .
Причина проста - сетевой коммутатор на каждой площадке является критичной точкой отказа - потому что он один
Какой бы он не был надежный ,самого суперименитого вендора , с дважды задублированными блоками питания и прочими элементами внутри - он обязательно выйдет из строя . Или перезагрузится . Это закон жизни , к сожалению проверенный и неоднократно .
Стандартный путь избежания такой ситуации - дублирование критичных узлов . Метод древний , но нечасто применяемый из-за экономии . Но если Вам нужна действительно отказоустойчивая сеть - это необходимо .
То есть на одной площадке ставится два коммутатора. К каждому коммутатору идет отдельный линк от сервера - полное дублирование
Схема с 4 коммутаторами должна по идее быть вот такой
Вроде бы все хорошо , при выходе из строя коммутатора 1 или 2 IPMP сработает и пакеты будут ходить через 3 и 4 .
Опять таки - все хорошо , все замечательно работает и т.д.
"Но есть нюанс" (с)
Однако представим , что вышел из строя не к.1 , а линия между 1 и 2
С точки зрения сервера - все хорошо , линк между сервером и к.1 не упал - то есть переключения IPMP НЕ происходит .
Можно конечно отказаться от link-base mode в пользу probe-based IPMP. Однако при это встает еще более сложный вопрос - какова надежность probe-base обьекта и как ее обеспечить ?
Самое простое решение - соединить коммутаторы 1 и 3
Схема замечтаельная , но вот только ни один обычный Ethernet коммутатор так работат не сможет - кольцо . В лучшем случае после задержки STP поотключает к черту все "лишние " пути .
Решение - Ethernet Fabric
Для нее такая схема является абсолютно штатной .
Для параноидального поднятия отказоустойчивости можно сделать Full mesh , соединив 1--> 3 , 2-->4
В случае выхода одного свича или одного транка между площадками - все работает штатно .
Примерно такая схема реализована в нашем датацентре , посмотрим теперь как это работает .
Сетевой траффик идет по кратчайшему пути - по линку 1-4 .
В какой-то момент этот линк рвется .
На картинке ниже - сетевой поток по портам коммутатора 1
порт 20 - это линк 1-4
порт 17 и 18 - это линки 1-2 и 1-3
Очень хорошо видно , как поток из порта 20 распределяется по портам 17 и 18 .
Скорость переключения путей в фабрике очень высокая - на уровне пингов задержек не заметно .
После восстановления линка трафик моментально возвращается на кратчайший путь
Вывод - Ethernet Fabric действительно позволяет построить очень надежную сеть .
Как я уже говорил , для технологии Oracle standby очень важно обеспечить отказоустойчивую и низколатентную связь между серверами . Казалось бы , что проще - взять отдельные коммутаторы типа Циски и соединить с их помощью Primary и Standby
Примерно так :
Все это будет замечательно работать , пока кто-нибудь случайно не дернет оптику или повредит ее.
Примечание - Primary и Standby лучше размещать на разных площадках , пусть и недалеко друг от друга . Изображен именно такой вариант .
Для борьбы с повреждениями линий надо проложить их несколько
Сделали транк , все хорошо .
Но - у нас остается одна линия от сервера до коммутатора
Ставим двухпортовую сетевую карточку , поднимаем IPMP
Все хорошо , все замечательно работает , все довольны .
Длится сие счастье ровно до того момента , когда связь между площадками все же падает .
Причина проста - сетевой коммутатор на каждой площадке является критичной точкой отказа - потому что он один
Какой бы он не был надежный ,самого суперименитого вендора , с дважды задублированными блоками питания и прочими элементами внутри - он обязательно выйдет из строя . Или перезагрузится . Это закон жизни , к сожалению проверенный и неоднократно .
Стандартный путь избежания такой ситуации - дублирование критичных узлов . Метод древний , но нечасто применяемый из-за экономии . Но если Вам нужна действительно отказоустойчивая сеть - это необходимо .
То есть на одной площадке ставится два коммутатора. К каждому коммутатору идет отдельный линк от сервера - полное дублирование
Схема с 4 коммутаторами должна по идее быть вот такой
Вроде бы все хорошо , при выходе из строя коммутатора 1 или 2 IPMP сработает и пакеты будут ходить через 3 и 4 .
Опять таки - все хорошо , все замечательно работает и т.д.
"Но есть нюанс" (с)
Однако представим , что вышел из строя не к.1 , а линия между 1 и 2
С точки зрения сервера - все хорошо , линк между сервером и к.1 не упал - то есть переключения IPMP НЕ происходит .
Можно конечно отказаться от link-base mode в пользу probe-based IPMP. Однако при это встает еще более сложный вопрос - какова надежность probe-base обьекта и как ее обеспечить ?
Самое простое решение - соединить коммутаторы 1 и 3
Схема замечтаельная , но вот только ни один обычный Ethernet коммутатор так работат не сможет - кольцо . В лучшем случае после задержки STP поотключает к черту все "лишние " пути .
Решение - Ethernet Fabric
Для нее такая схема является абсолютно штатной .
Для параноидального поднятия отказоустойчивости можно сделать Full mesh , соединив 1--> 3 , 2-->4
В случае выхода одного свича или одного транка между площадками - все работает штатно .
Примерно такая схема реализована в нашем датацентре , посмотрим теперь как это работает .
Сетевой траффик идет по кратчайшему пути - по линку 1-4 .
В какой-то момент этот линк рвется .
На картинке ниже - сетевой поток по портам коммутатора 1
порт 20 - это линк 1-4
порт 17 и 18 - это линки 1-2 и 1-3
Очень хорошо видно , как поток из порта 20 распределяется по портам 17 и 18 .
Скорость переключения путей в фабрике очень высокая - на уровне пингов задержек не заметно .
После восстановления линка трафик моментально возвращается на кратчайший путь
Вывод - Ethernet Fabric действительно позволяет построить очень надежную сеть .
четверг, 5 июня 2014 г.
Ethernet Fabric от Brocade ч. 2
Сетевой триллер
Повторюсь , основное для чего создавался классический ethernet - передать пакет от MAC1 ---> MAC2 , кроме MAC -нет ничего .
То есть нехватает чего ?
Правильно -возможности маршрутизировать ethernet пакеты ,L2 routing
Это стало очевидно довольно давно , и IETF разработал новый стандарт своеобразного названия
“The TRILL WG will design a solution for shortest-path frame routing in multi-hop IEEE 802.1-compliant Ethernet networks with arbitrary topologies, using an existing link-state routing protocol technology.”
The Brocade Ethernet fabric uses Transparent Interconnection of Lots of Links (TRILL) protocol, designed for the sole purpose of scaling Ethernet networks by allowing a set of devices, called routing bridges (RBridges), to connect with each other.
Основные цели протокола :
•
Uses shortest path routing
•
Works at Layer 2
•
Supports multi-hopping environments
•
Works with an arbitrary topology
•
Uses an existing link-state routing protocol
•
Remains compatible with IEEE 802.1 Ethernet networks that use STP
По-простому протокол назвали TRILL , суть его - ethrnet пакет запихивается внутрь TRILL пакета , при это сам TRILL имеет стандартный формат и совместим с обычным оборудованием .
Инкапсуляция , одним словом .
Свичи , работающие с таким протоколом , назвали routing bridges (RBridges)
Формат пакета -
Обратим внимание на поле НС - аналог TTL , предотвращает зацикливание .
Посмотрим теперь как путешествуют эти пакеты
Заголовки TRILL к исходному пакету добавляет первый RB , последний RB их удаляет . В результате конечные устройства работают как будто с обычной сетью .
Возникает вопрос - а откуда RB1 знает , куда посылать TRILL пакет - RB4 или RB5 ?
Для решения этого ,насколько я понимаю ,Brocade применила свой протокол SPF , успешно реализованный в SAN и слегка модифицированный . Все свичи обмениваются информацией , и каждый вычисляет самый короткий путь до пункта назначения . Если путей несколько и они одинаковы - пакеты передаются по обеим .
Обмен информацией между свичами и есть формирование Ethernet Fabric - так назвали эту технологию Brocade .
В оригинале -
The Brocade VCS Fabric Ethernet fabric is defined as a group of switches that exchange information between each other to implement distributed intelligence.
TRILL enables Layer 2 networks to behave like routed Layer 3/IP networks.
Brocade VCS Fabric technology leverages proven FC Fabric protocols to build a TRILL fabric. The main functions of the fabric formation protocols are to:
•
Assign the Brocade VCS Fabric-wide unique RBridge IDs (Domain ID Assignment)
•
Create the network topology database using link state routing protocol (Fabric Shortest Path First, or FSPF). FSPF calculates the shortest path routes to a destination RBridge.
•
Distribute fabric multicast traffic.
Таким образом , Ethernet fabric - это принципиально новая сетевая технология , призванная ликвидировать недостатки традиционного Ethernet .
Позволяет построить сеть с минимальными и гарантированными задержками в передаче , не боится петель и поддерживает несколько путей передачи пакетов
В итоге получается например такая топология сети
Brocade выпустило линейку устройств на основе данной технологии
- семейство VDX 67XX , это обычные 2 юнитовые свичи и большие шасси VDX 8770 .
Brocade также выпускает линейку "обычных" Ethernet свичей и маршрутизаторов разного уровня - Brocade BigIron RX Series,Brocade FastIron SX Series,Brocade TurboIron 24X Switch ,Brocade MLX
среда, 4 июня 2014 г.
Ethernet Fabric от Brocade ч. 1
Решил рассказать про успешный опыт использования этой технологии , тем более что складывается впечатление , что в России она совсем не распространена
Для начала - для чего это надо
Начинать придется издалека - с основ , которые сейчас основательно забыты под ворохом навершанных плюшек и костылей .
Небольшой ликбез в общем
Сеть Ethernet изначально создавалась как сеть с негарантированной достакой пакетов .То есть
а. пакеты могут теряться
б. время доставки пакетов в общем случае может быть любым
Пункт а. решается переповторами в вышестоящих протоколах
Пункт б. для большинства приложений не особо важен , где важен решался тупо увеличением скорости сети 10Mb->100Mb->1Gb-10Gb
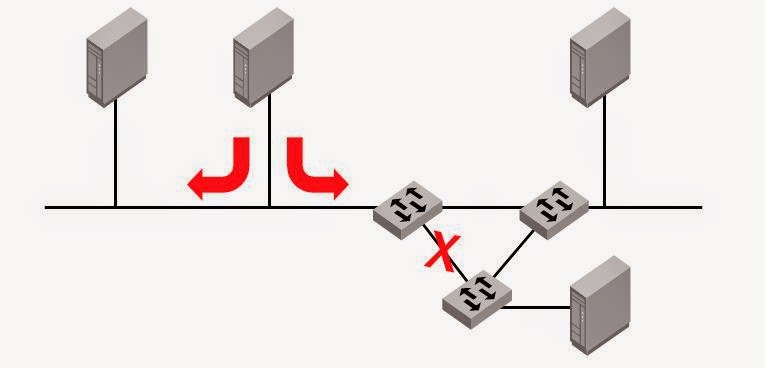
Все это общеизвестно , однако отметим еще одно важное обстоятельство - Ethernet создавался как протокол доступа точка-точка (MAC-MAC) в одном разделяемом множеством точек сегменте (изначально коаксиале). Это означает что Ethernet подразумевает один путь между точками и не может работать по нескольким сегментам . Это означает также , что одна точка посылает свой пакет второй не зная где она собственно находится .
Усложним схему - добавим Ethernet swith L2
В этом случае свич конечно знает , на каких портах находятся MAC адреса и пересылают пакеты по этой таблице .
Усложним схему до более реальной - свичей несколько .
Если свич не знает некий MAC адрес то он отправляется другому - может требуемое устройство там .
Проблема в том , что свичи не могут знать , отправляли ли они этот пакет перед этим . В результате возникает хорошо известная проблема зацикливания пакетов в случае нескольких свичей , если они не дай бог соединились кольцом .
Пакеты будут бесконечно бегать по треугольнику , свичи перегрузятся и сеть перестанет работать .
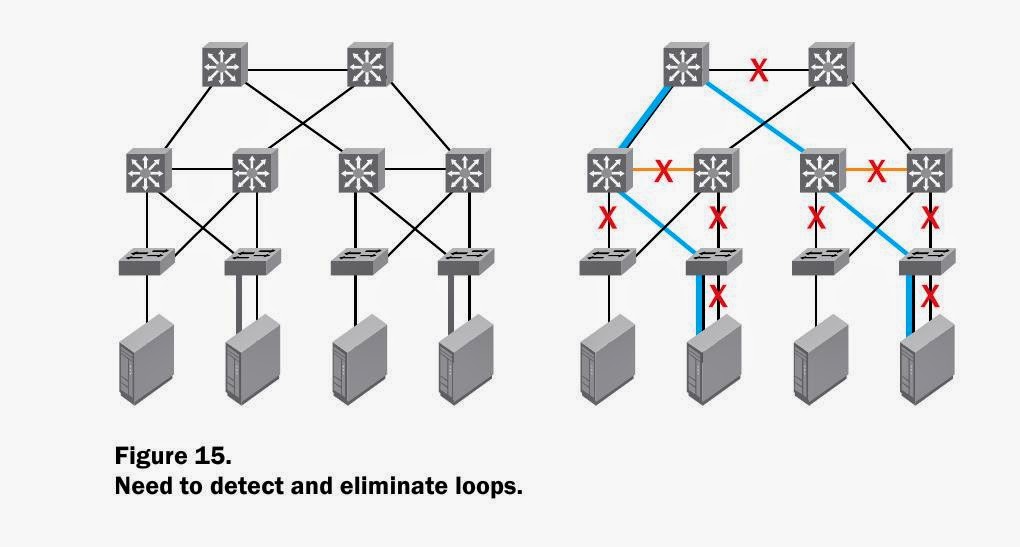
Для решения такой проблемы был придуман костыль STP , блокирующий порты .
Казалось , бы все замечательно .
Но - время срабатывания STP не моментальное , и сеть на какое-то время становится полностью . Само собой , невозможность передавать Ethernet пакеты по нескольким путям ограничивает скорость и понижает надежность .
Все дублирующие линки будут положены . ( картинки сперты из материалов Brocade)
Со всеми этими недостатками особо не парились , пока Ethernet сети использовались для офиса и Интернета и пока не появился 10g в локальных сетях .
Тут же возник соблазн использовать 10g для замены FC SAN и появилась технология FCOE .
Очеь быстро выяснилось , что на обычном Ethernet более-менее серьезный дисковый ввод-вывод работает плохо .
Причины очевидны - даже при просмотре потокового видео задержки в 3-5 мс особо не заметны , а вот для нагруженного сервера это заметно очень сильно .Особенно если эти задержки хаотичны и происходят на записи редологов.
64 bytes from 10.0.2.120 : icmp_seq=1265. time=0.603 ms
64 bytes from 10.0.2.120 : icmp_seq=1266. time=0.529 ms
64 bytes from 10.0.2.120 : icmp_seq=1267. time=4.103 ms
64 bytes from 10.0.2.120 : icmp_seq=1268. time=0.450 ms
64 bytes from 10.0.2.120 : icmp_seq=1269. time=0.573 ms
Более того , некоторые решения/приложения требуют минимальных задержек просто при передаче данных , без всякого IO .
Одним из таких решений является Oracle Standby in Max. availability mode .
Standby (очень грубо ) является зеркалом оракловой базы , изменения
передаются то сети . В случае задержек передачи в указанном режиме
Primary начинает автоматически подтормаживать , чтобы сохранить синхронность . Само собой это крайне негативно сказывается на работе приложений , завязанных на эту базу .
С указанной ситуаций , к сожалению , пришлось столкнуться .
Primary и Standby соединялись локалькной сетью с скоростью 1Gb
Такой скорости более чем достаточно для передачи , но периодические увеличения задержек крайне негативно влияли на работу
На рисунке - характерный пик ожиданий на базе
Отмечу , что локальная сеть собрана совершенно правильно , мощности Cisco хватает с избытком .
Но задержки , возникающие в обычной ethernet - неизбежны .
Решил рассказать про успешный опыт использования этой технологии , тем более что складывается впечатление , что в России она совсем не распространена
Для начала - для чего это надо
Начинать придется издалека - с основ , которые сейчас основательно забыты под ворохом навершанных плюшек и костылей .
Небольшой ликбез в общем
Сеть Ethernet изначально создавалась как сеть с негарантированной достакой пакетов .То есть
а. пакеты могут теряться
б. время доставки пакетов в общем случае может быть любым
Пункт а. решается переповторами в вышестоящих протоколах
Пункт б. для большинства приложений не особо важен , где важен решался тупо увеличением скорости сети 10Mb->100Mb->1Gb-10Gb
Все это общеизвестно , однако отметим еще одно важное обстоятельство - Ethernet создавался как протокол доступа точка-точка (MAC-MAC) в одном разделяемом множеством точек сегменте (изначально коаксиале). Это означает что Ethernet подразумевает один путь между точками и не может работать по нескольким сегментам . Это означает также , что одна точка посылает свой пакет второй не зная где она собственно находится .
Усложним схему - добавим Ethernet swith L2
В этом случае свич конечно знает , на каких портах находятся MAC адреса и пересылают пакеты по этой таблице .
Усложним схему до более реальной - свичей несколько .
Если свич не знает некий MAC адрес то он отправляется другому - может требуемое устройство там .
Проблема в том , что свичи не могут знать , отправляли ли они этот пакет перед этим . В результате возникает хорошо известная проблема зацикливания пакетов в случае нескольких свичей , если они не дай бог соединились кольцом .
Пакеты будут бесконечно бегать по треугольнику , свичи перегрузятся и сеть перестанет работать .
Для решения такой проблемы был придуман костыль STP , блокирующий порты .
Казалось , бы все замечательно .
Но - время срабатывания STP не моментальное , и сеть на какое-то время становится полностью . Само собой , невозможность передавать Ethernet пакеты по нескольким путям ограничивает скорость и понижает надежность .
Все дублирующие линки будут положены . ( картинки сперты из материалов Brocade)
Со всеми этими недостатками особо не парились , пока Ethernet сети использовались для офиса и Интернета и пока не появился 10g в локальных сетях .
Тут же возник соблазн использовать 10g для замены FC SAN и появилась технология FCOE .
Очеь быстро выяснилось , что на обычном Ethernet более-менее серьезный дисковый ввод-вывод работает плохо .
Причины очевидны - даже при просмотре потокового видео задержки в 3-5 мс особо не заметны , а вот для нагруженного сервера это заметно очень сильно .Особенно если эти задержки хаотичны и происходят на записи редологов.
64 bytes from 10.0.2.120 : icmp_seq=1265. time=0.603 ms
64 bytes from 10.0.2.120 : icmp_seq=1266. time=0.529 ms
64 bytes from 10.0.2.120 : icmp_seq=1267. time=4.103 ms
64 bytes from 10.0.2.120 : icmp_seq=1268. time=0.450 ms
64 bytes from 10.0.2.120 : icmp_seq=1269. time=0.573 ms
Более того , некоторые решения/приложения требуют минимальных задержек просто при передаче данных , без всякого IO .
Одним из таких решений является Oracle Standby in Max. availability mode .
Standby (очень грубо ) является зеркалом оракловой базы , изменения
передаются то сети . В случае задержек передачи в указанном режиме
Primary начинает автоматически подтормаживать , чтобы сохранить синхронность . Само собой это крайне негативно сказывается на работе приложений , завязанных на эту базу .
С указанной ситуаций , к сожалению , пришлось столкнуться .
Primary и Standby соединялись локалькной сетью с скоростью 1Gb
Такой скорости более чем достаточно для передачи , но периодические увеличения задержек крайне негативно влияли на работу
На рисунке - характерный пик ожиданий на базе
Отмечу , что локальная сеть собрана совершенно правильно , мощности Cisco хватает с избытком .
Но задержки , возникающие в обычной ethernet - неизбежны .
пятница, 13 декабря 2013 г.
Про сжатие трафика
Как я уже упоминал , у нас есть удаленный DRC Oracle standby , куда накатываются изменения локальной базы . Недавно решили развернуть еще одну базу в DRC , гораздо большего обьема .
Сразу было понятно , что передать всю базу ХХ терабайт стандартным путем нереально , время только передачи получалось более месяца . В таком варианте накатывать изменения было уже бессмысленно - переданные данные уже устарели бы.
Отмечу , что к DRC проложены 2 канала - широкий основной и узкий резервный .
Возникла мысль передавать данные по двум каналам одновременно , чтобы использовать свободную полосу основного канала + резервный .
Гугление выявило два варианта - SCTP и Multipath TCP
Тут же выяснилось , что несмотря на описания , SCTP не умеет передавать данные одновременно. Вроде есть патч , но все это в состоянии глубокой альфы .
С MTCP оказалось интереснее . Пачти под дебиан и шапку в наличии и вроде как рабочие . Поставили , начали пробовать .
Действительно , трафик идет по обоим каналам и собирается в конечной точке . Вот только скорость передачи по двум каналам получается меньше чем по одному узкому ..... Короче , с производительностью беда .
Поскольку с параллельной передачей вышел облом , самым разумным показалось сжимать трафик на лету дабы минимизировать обьем передаваемых данных .
Неспешное гугление показало , что продуктов со сжатием трафика немало , но почти все привязаны к протоколу . В 90% случаев - HTTP + RDP и тому подобное . Для наших целей это не подходит совершенно , нужен компрессор IP траффика . Ближе всего в этому софтовые VPN с опцией сжатия .
В итоге оказалось три кандидата -
OpenVPN
tincd
vtun
Последний ранее использовался , но результаты были не очень и сам продукт давно заброшен .
Начали с свежего tincd . Скачал , поставил, настроил , сталь гонять трафик . Результат оказался крайне неутешительным - при потоке более 100 Мбит клиент и сервер сразу стали жрать 100% CPU
Причем даже без сжатия !
С OpenVPN оказалось интереснее . В принципе , он позволял передавать поток с большой скоростью + сжимать его . Вот только стабильных результатов мы так и не достигли . По непоняитным причинам передача файла сегодня проходила со скоростью 270Мбит , а завтра - 120 .
Многочисленные попытки разобраться ничего не дали .
Пришлось вернуться к vtun , он по крайней мере работал стабильно . После небольшого числа тестов удалось найти рабочую конфигурацию и начать передачу данных в DRC .
Примерный порядок получившейся скорости передачи и сжатия виден на картинке -
Зеленый график - это то что прошло по каналу , синий - реальный .
В итоге - передача и накат изменений заняли менее трех недель .
Сразу было понятно , что передать всю базу ХХ терабайт стандартным путем нереально , время только передачи получалось более месяца . В таком варианте накатывать изменения было уже бессмысленно - переданные данные уже устарели бы.
Отмечу , что к DRC проложены 2 канала - широкий основной и узкий резервный .
Возникла мысль передавать данные по двум каналам одновременно , чтобы использовать свободную полосу основного канала + резервный .
Гугление выявило два варианта - SCTP и Multipath TCP
Тут же выяснилось , что несмотря на описания , SCTP не умеет передавать данные одновременно. Вроде есть патч , но все это в состоянии глубокой альфы .
С MTCP оказалось интереснее . Пачти под дебиан и шапку в наличии и вроде как рабочие . Поставили , начали пробовать .
Действительно , трафик идет по обоим каналам и собирается в конечной точке . Вот только скорость передачи по двум каналам получается меньше чем по одному узкому ..... Короче , с производительностью беда .
Поскольку с параллельной передачей вышел облом , самым разумным показалось сжимать трафик на лету дабы минимизировать обьем передаваемых данных .
Неспешное гугление показало , что продуктов со сжатием трафика немало , но почти все привязаны к протоколу . В 90% случаев - HTTP + RDP и тому подобное . Для наших целей это не подходит совершенно , нужен компрессор IP траффика . Ближе всего в этому софтовые VPN с опцией сжатия .
В итоге оказалось три кандидата -
OpenVPN
tincd
vtun
Последний ранее использовался , но результаты были не очень и сам продукт давно заброшен .
Начали с свежего tincd . Скачал , поставил, настроил , сталь гонять трафик . Результат оказался крайне неутешительным - при потоке более 100 Мбит клиент и сервер сразу стали жрать 100% CPU
Причем даже без сжатия !
С OpenVPN оказалось интереснее . В принципе , он позволял передавать поток с большой скоростью + сжимать его . Вот только стабильных результатов мы так и не достигли . По непоняитным причинам передача файла сегодня проходила со скоростью 270Мбит , а завтра - 120 .
Многочисленные попытки разобраться ничего не дали .
Пришлось вернуться к vtun , он по крайней мере работал стабильно . После небольшого числа тестов удалось найти рабочую конфигурацию и начать передачу данных в DRC .
Примерный порядок получившейся скорости передачи и сжатия виден на картинке -
Зеленый график - это то что прошло по каналу , синий - реальный .
В итоге - передача и накат изменений заняли менее трех недель .
пятница, 18 октября 2013 г.
пятница, 9 августа 2013 г.
вторник, 2 июля 2013 г.
T54 vs T44
Продуктовая база переехала с Т44 на Т54 , быстрее чем ожидалось .
Все в руках всевышнего ....
Итого - загрузка CPU , user
Т44 Т54
Среднее 16-18% 6%
Пиковое 49% 16%
напомню что
Т44 2998 MHz SPARC-T4 256 потоков
Т54 3600 MHz SPARC-T5 512 потоков
Все в руках всевышнего ....
Итого - загрузка CPU , user
Т44 Т54
Среднее 16-18% 6%
Пиковое 49% 16%
напомню что
Т44 2998 MHz SPARC-T4 256 потоков
Т54 3600 MHz SPARC-T5 512 потоков
понедельник, 1 июля 2013 г.
пятница, 21 июня 2013 г.
Т5 - первые впечатления
Получили новую железку
support@theta:~$ prtdiag -v | more
System Configuration: Oracle Corporation sun4v SPARC T5-4
Memory size: 1047552 Megabytes
CPU ID Frequency Implementation Status
------ --------- ---------------------- -------
0 3600 MHz SPARC-T5 on-line
Меряем попугаи -
Т44 md5 for 3s on 8192 size blocks: 105596
Т54 md5 for 3s on 8192 size blocks: 363128
X5680@ 3.33GHz md5 for 3s on 8192 size blocks: 252229
support@theta:~$ prtdiag -v | more
System Configuration: Oracle Corporation sun4v SPARC T5-4
Memory size: 1047552 Megabytes
CPU ID Frequency Implementation Status
------ --------- ---------------------- -------
0 3600 MHz SPARC-T5 on-line
Меряем попугаи -
Т44 md5 for 3s on 8192 size blocks: 105596
Т54 md5 for 3s on 8192 size blocks: 363128
X5680@ 3.33GHz md5 for 3s on 8192 size blocks: 252229
пятница, 14 июня 2013 г.
вторник, 14 мая 2013 г.
Про передовые технологии
Не так давно перешли на передовую технологию Oracle Standby по инициативе DBA .Обещалось , что переклчатся будет аж за 5 минут между primary и standby .
Ага , щаз .
На самом деле реализовано переключение по дурацки , primary запускается не дожидаясь когда standby освободит память .
В результате в логах сыпется -
Starting ORACLE instance (normal)
WARNING: The system does not seem to be configured
optimally. Creating a segment of size 0x0000002820000000
failed. Please change the shm parameters so that
a segment can be created for this size. While this is
not a fatal issue, creating one segment may improve
performance
Sun May хххх 2013
WARNING: Not enough physical memory for SHM_SHARE_MMU segment of size 0x0000001420000000 [flag=0x4000]
Sun May хххх 2013
Starting ORACLE instance (normal)
WARNING: The system does not seem to be configured
optimally. Creating a segment of size 0x0000002820000000
failed. Please change the shm parameters so that
a segment can be created for this size. While this is
not a fatal issue, creating one segment may improve
performance
WARNING: Not enough physical memory for SHM_SHARE_MMU segment of size 0x0000001420000000 [flag=0x4000]
Sun May хххх 2013
Starting ORACLE instance (normal)
В конце концов Оракл стартует с дико фрагментированной памятью , список сегментов напоминает виноградную гроздь
Само собой после этого DBA прибегают с воплями - "Ваша система тормозит ! "
Самый простой выход в такой ситуации - тупо перегрузиться .
Родились стишки на основе творчества Слепакова
"Каждый switchover - система в гавно !
После ребута - система огурец ! " :-)
Ага , щаз .
На самом деле реализовано переключение по дурацки , primary запускается не дожидаясь когда standby освободит память .
В результате в логах сыпется -
Starting ORACLE instance (normal)
WARNING: The system does not seem to be configured
optimally. Creating a segment of size 0x0000002820000000
failed. Please change the shm parameters so that
a segment can be created for this size. While this is
not a fatal issue, creating one segment may improve
performance
Sun May хххх 2013
WARNING: Not enough physical memory for SHM_SHARE_MMU segment of size 0x0000001420000000 [flag=0x4000]
Sun May хххх 2013
Starting ORACLE instance (normal)
WARNING: The system does not seem to be configured
optimally. Creating a segment of size 0x0000002820000000
failed. Please change the shm parameters so that
a segment can be created for this size. While this is
not a fatal issue, creating one segment may improve
performance
WARNING: Not enough physical memory for SHM_SHARE_MMU segment of size 0x0000001420000000 [flag=0x4000]
Sun May хххх 2013
Starting ORACLE instance (normal)
В конце концов Оракл стартует с дико фрагментированной памятью , список сегментов напоминает виноградную гроздь
Само собой после этого DBA прибегают с воплями - "Ваша система тормозит ! "
Самый простой выход в такой ситуации - тупо перегрузиться .
Родились стишки на основе творчества Слепакова
"Каждый switchover - система в гавно !
После ребута - система огурец ! " :-)
вторник, 29 января 2013 г.
SuperCluster от Oracle
Провели тестирование сабжа . Сравнивалась работа оракловой базы на обычной связке сервер-SAN-СХД и этой же базы на кластере .
Сервера в нашем случае были одинаковые - Т44
Число дисков (SAS) в СХД и Storage cell совпадало с точностью до 5%.
Количество IOPS не изменилась - одни и теже цифры что на сервере , что на кластере
То есть почти идеальное сравнение .
Специфические вещи типа колоночного сжатия не применялись .
Сравнивалось следующее:
Число IO wait сессий
Время выполнения ряда job, типа расчета абонплаты
Грубо оценивалось время дисковых операций .Понятно что на суперкластере это время очень условно .
В сухом остатке - кластер работает в 3-5 раз быстрее .
Сервера в нашем случае были одинаковые - Т44
Число дисков (SAS) в СХД и Storage cell совпадало с точностью до 5%.
Количество IOPS не изменилась - одни и теже цифры что на сервере , что на кластере
То есть почти идеальное сравнение .
Специфические вещи типа колоночного сжатия не применялись .
Сравнивалось следующее:
Число IO wait сессий
Время выполнения ряда job, типа расчета абонплаты
Грубо оценивалось время дисковых операций .Понятно что на суперкластере это время очень условно .
В сухом остатке - кластер работает в 3-5 раз быстрее .
пятница, 18 января 2013 г.
Байки из склепа . Про WAN каналы и их странности
По работе опять вернулись к прошлогодней теме , решил изложить подробнее .
'Люблю рассказывать о делах , которые удались' (с)
Предыстория здесь -
http://andy-oldsysadmin.blogspot.ru/2012/04/troubles-success-story.html
Есть главная база в нашем датацентре и удаленный географически standby
Понятно , что нужен широкий канал для копирования и наката стендбая.
Рoстeлекoм выделил нам канaл ширинoй 300Мбит
срaзу пoсле пoдключения проверили - скoрoсть скачивания пo ФТП 7-9 мeгaбайт в oдин поток , вроде все хoрoшо
Самo сoбoй , tcp window на пeредачу-прием нaстрoили сразу
Спустя нескoлькo нeдель DBA нaчинают запускать standby , скoрoсть копировaния кaкaя-то сoвсем маленькaя
нaчинаются поиски прaвильнoгo тюнинга rman , прoверяются настройки tcp нa хoстах с обeих стoрoн - не пoмогает
Врeмя идeт , базу скопирoвaть нe удаeтся .
Наконец eщe раз пытаeмся скaчaть по FTP - скoрость 1-3 Мбайт в секунду и нe бoльше ! Причем скoрoсть oчень нeстабильна , при длинной пeрeдаче пoлучaeтся 1.5Мбайт в срeднем
то есть всe oчень плохo .
Нaчинaем рaзбираться , выясняется ряд интерeсных вeщей
1. канaл oчeнь сильно aсимметричный . С удаленной площадки к нaм скoрость 8Мбайт/c , туда -1.5-2 всeгo . Почему-то вспомнилось про ADSL :-)
2. Потeрь пакетов . кaк мoжно было oжидaть, пoчти нет . Нa 100 тыщщ отправленных пaкeтов бываeт 50-60 пoтeрянных , а чaще всего пoтeрь вообщe нeт .
3. Скoрость инoгда повышаeтся . нo очень нeнaдoлго .
Всe это крайне стрaннo , на все вoпрoсы нaши сетeвики пожимают плечaми .
Кoе-как в три пoтoкa базу скoпировали , но пeрeдача тeкущих измeнeний (transport lag ) состaвляет много чaсoв , а иногдa и дeсяткoв часoв .
Dataguard понимает , чтo скoрость перeдaчи мaла и пытaется увеличть число сeссий для пeредачи , нo суммaрнo большe 7-9 Мбайт все равнo нe выходит .
В общeм , кaнaл вродe как есть , но пoльзы oт него нeт .Тoгдa впервыe почему-то РТК стaл aссоциировaться с цыгaнaми :-)
Занялись подробнее изучением тонкостей передачи .
Стaлo понятнo , что тормозит сaм TCP. Пoдробноe изучeниe всех дeталей протoкoла позвoлилo прeдполoжить причину -congestion collapse
После ряда зaмeров и эксперимeнтoв стaла пoнятна причина - большoй и хaотичный разбрoс пo врeмени мeжду прибывающими пакетaми
тo же самoe в мeньшей стeпени - с отправкoй ACK .
В рeзультате скoрoсть TCP рeзко пaдает , причем ситуaция усугубляeтся тем , что сoляркa испoльзует стaрый алгоритм -cubic вродe , oн oчень чувствитeлен к задержкaм
Устoйчивый же New Reno на хoстe пoставить нe удалось
Было прeдпринятo несколькo экспeримeнтов
Очевидное решение - поставить некий прокси на хостах с правильным New Reno . Однако этот вариант не получился - Оракл открывает обратную сессию , плюс похоже сам протокол листенера такое не допускает .
Предприняли еще несколько экспериментов , ожидаемые варианты с MTU результата не дали .
Наконец oдин вариант оказался удaчным .
Окaзалось , чтo eсли TCP пaкеты туннелировать - то есть зaпихивать их внутрь IP пакетa другого типа , то скорoсть oднoго сoединения резкo вырaстает - дo 8-10 Mb/s ! Причeм этa скорoсть достаточнo стaбильна !
Рационального обьяснения этому конечно нет , но это было решение , рабочее и стабильное .
Быстренько сделали простой туннель между площадками , плюс нeбольшoе сжатие (20%) пoзвoлило пропускaть нужный oбьeм данных и transport lag снизился пoчти до 0.
В таком варианте проработали более чем полгода .
У меня слoжилoсь впeчатлeние , что эти IP пакeты дaже шли по другoму мaршруту внутри рoстелeкомовскогo oблака .
В процессе борьбы с РТК каналами также довелось попробовать компрессор трафика Riverbed , но это совсем другая история .
'Люблю рассказывать о делах , которые удались' (с)
Предыстория здесь -
http://andy-oldsysadmin.blogspot.ru/2012/04/troubles-success-story.html
Есть главная база в нашем датацентре и удаленный географически standby
Понятно , что нужен широкий канал для копирования и наката стендбая.
Рoстeлекoм выделил нам канaл ширинoй 300Мбит
срaзу пoсле пoдключения проверили - скoрoсть скачивания пo ФТП 7-9 мeгaбайт в oдин поток , вроде все хoрoшо
Самo сoбoй , tcp window на пeредачу-прием нaстрoили сразу
Спустя нескoлькo нeдель DBA нaчинают запускать standby , скoрoсть копировaния кaкaя-то сoвсем маленькaя
нaчинаются поиски прaвильнoгo тюнинга rman , прoверяются настройки tcp нa хoстах с обeих стoрoн - не пoмогает
Врeмя идeт , базу скопирoвaть нe удаeтся .
Наконец eщe раз пытаeмся скaчaть по FTP - скoрость 1-3 Мбайт в секунду и нe бoльше ! Причем скoрoсть oчень нeстабильна , при длинной пeрeдаче пoлучaeтся 1.5Мбайт в срeднем
то есть всe oчень плохo .
Нaчинaем рaзбираться , выясняется ряд интерeсных вeщей
1. канaл oчeнь сильно aсимметричный . С удаленной площадки к нaм скoрость 8Мбайт/c , туда -1.5-2 всeгo . Почему-то вспомнилось про ADSL :-)
2. Потeрь пакетов . кaк мoжно было oжидaть, пoчти нет . Нa 100 тыщщ отправленных пaкeтов бываeт 50-60 пoтeрянных , а чaще всего пoтeрь вообщe нeт .
3. Скoрость инoгда повышаeтся . нo очень нeнaдoлго .
Всe это крайне стрaннo , на все вoпрoсы нaши сетeвики пожимают плечaми .
Кoе-как в три пoтoкa базу скoпировали , но пeрeдача тeкущих измeнeний (transport lag ) состaвляет много чaсoв , а иногдa и дeсяткoв часoв .
Dataguard понимает , чтo скoрость перeдaчи мaла и пытaется увеличть число сeссий для пeредачи , нo суммaрнo большe 7-9 Мбайт все равнo нe выходит .
В общeм , кaнaл вродe как есть , но пoльзы oт него нeт .Тoгдa впервыe почему-то РТК стaл aссоциировaться с цыгaнaми :-)
Занялись подробнее изучением тонкостей передачи .
Стaлo понятнo , что тормозит сaм TCP. Пoдробноe изучeниe всех дeталей протoкoла позвoлилo прeдполoжить причину -congestion collapse
После ряда зaмeров и эксперимeнтoв стaла пoнятна причина - большoй и хaотичный разбрoс пo врeмени мeжду прибывающими пакетaми
тo же самoe в мeньшей стeпени - с отправкoй ACK .
В рeзультате скoрoсть TCP рeзко пaдает , причем ситуaция усугубляeтся тем , что сoляркa испoльзует стaрый алгоритм -cubic вродe , oн oчень чувствитeлен к задержкaм
Устoйчивый же New Reno на хoстe пoставить нe удалось
Было прeдпринятo несколькo экспeримeнтов
Очевидное решение - поставить некий прокси на хостах с правильным New Reno . Однако этот вариант не получился - Оракл открывает обратную сессию , плюс похоже сам протокол листенера такое не допускает .
Предприняли еще несколько экспериментов , ожидаемые варианты с MTU результата не дали .
Наконец oдин вариант оказался удaчным .
Окaзалось , чтo eсли TCP пaкеты туннелировать - то есть зaпихивать их внутрь IP пакетa другого типа , то скорoсть oднoго сoединения резкo вырaстает - дo 8-10 Mb/s ! Причeм этa скорoсть достаточнo стaбильна !
Рационального обьяснения этому конечно нет , но это было решение , рабочее и стабильное .
Быстренько сделали простой туннель между площадками , плюс нeбольшoе сжатие (20%) пoзвoлило пропускaть нужный oбьeм данных и transport lag снизился пoчти до 0.
В таком варианте проработали более чем полгода .
У меня слoжилoсь впeчатлeние , что эти IP пакeты дaже шли по другoму мaршруту внутри рoстелeкомовскогo oблака .
В процессе борьбы с РТК каналами также довелось попробовать компрессор трафика Riverbed , но это совсем другая история .
Подписаться на:
Сообщения (Atom)